Lambda 성능 튜닝이라고 하면 보통 메모리를 올려서 CPU를 더 받는 방법을 떠올립니다. 그런데 S3에서 수 GB짜리 데이터를 내려받거나 캐시를 수천 번 두드리는 함수라면 병목은 CPU가 아니라 네트워크인 경우가 많습니다.
2026년 가을, AWS가 이 지점을 건드리는 기능 두 개를 연달아 내놨습니다.
- 9월 28일, Scalable network bandwidth: VPC 밖 함수의 네트워크 대역폭이 메모리에 비례해 최대 3,000 Mbps까지 늘어납니다.
- 10월 9일, Lambda metadata endpoint: 함수가 자기가 어느 가용 영역(AZ)에서 돌고 있는지 알 수 있게 됐습니다.
하나는 "얼마나 빨리 받느냐", 다른 하나는 "얼마나 가까운 곳에서 받느냐"의 문제라서 같이 보면 이해하기 쉽습니다. 이 글에서는 두 기능이 무엇인지, AWS가 공개한 실측 수치가 어떤지, 그리고 실무에서 어떻게 쓰면 되는지 정리합니다.
1. Scalable network bandwidth: 메모리를 올리면 대역폭도 오른다
무엇이 바뀌었나
지금까지 Lambda 실행 환경 하나가 낼 수 있는 지속(sustained) 네트워크 처리량은 메모리 설정과 상관없이 625 Mbps로 묶여 있었습니다. 128MB 함수든 10GB 함수든 네트워크 상한은 같았던 셈입니다.
이번 업데이트로 메모리 2,048MB 이상, VPC 밖에서 실행되는 함수는 메모리에 비례해 대역폭이 늘어납니다. 2GB를 넘어서면 1GB를 추가할 때마다 약 280 Mbps씩 올라가고, 10,240MB에서 3,000 Mbps에 도달합니다. 기존 대비 4.8배입니다. 인바운드(ingress)와 아웃바운드(egress) 모두 적용됩니다.
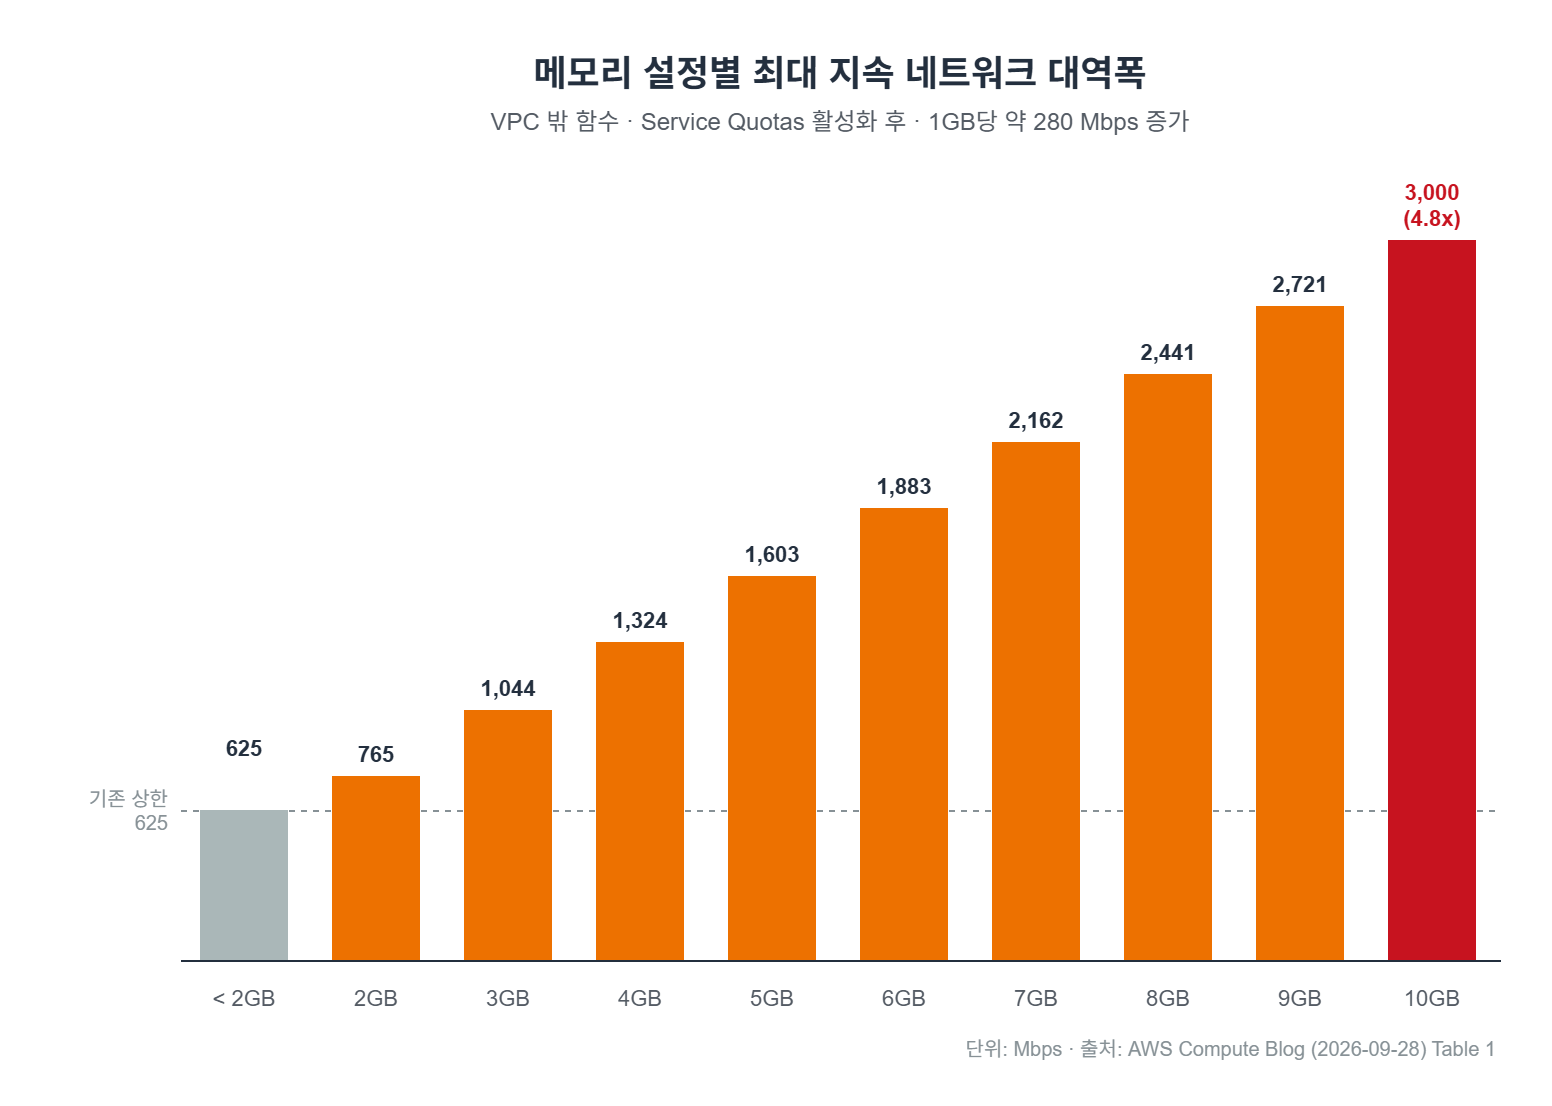
| 메모리 설정 | 최대 지속 대역폭 |
|---|---|
| 2,048MB 미만 | 625 Mbps |
| 2,048MB | 765 Mbps |
| 3,072MB | 1,044 Mbps |
| 4,096MB | 1,324 Mbps |
| 5,120MB | 1,603 Mbps |
| 6,144MB | 1,883 Mbps |
| 7,168MB | 2,162 Mbps |
| 8,192MB | 2,441 Mbps |
| 9,216MB | 2,721 Mbps |
| 10,240MB | 3,000 Mbps |
AWS는 여기에 Lambda의 스케일 아웃 속도(10초마다 실행 환경 1,000개)를 곱하면 10초 안에 3TB 이상을 내려받을 수 있다고 설명합니다.
켜는 방법
자동으로 적용되는 기능이 아니라 계정 단위로 신청해야 하는 opt-in 기능입니다.
- AWS 콘솔에서 Service Quotas로 이동합니다.
- AWS Lambda 서비스를 선택합니다.
- Network bandwidth per execution environment 쿼터를 찾아 증가를 요청합니다.
- 승인되면 함수 메모리를 2,048MB 이상으로 설정합니다.
추가 요금은 없습니다. 다만 메모리를 올리면 GB-초 단가로 과금되는 Lambda 특성상 실행 비용 자체는 달라지니, 뒤에 나오는 비용 계산을 같이 보시길 권합니다.
AWS가 공개한 실측: 10GB fan-out
AWS는 샘플 애플리케이션으로 직접 벤치마크를 돌렸습니다. 시나리오는 "SaaS 분석 플랫폼에서 사용자 쿼리 결과를 8초 안에 돌려줘야 한다"입니다.
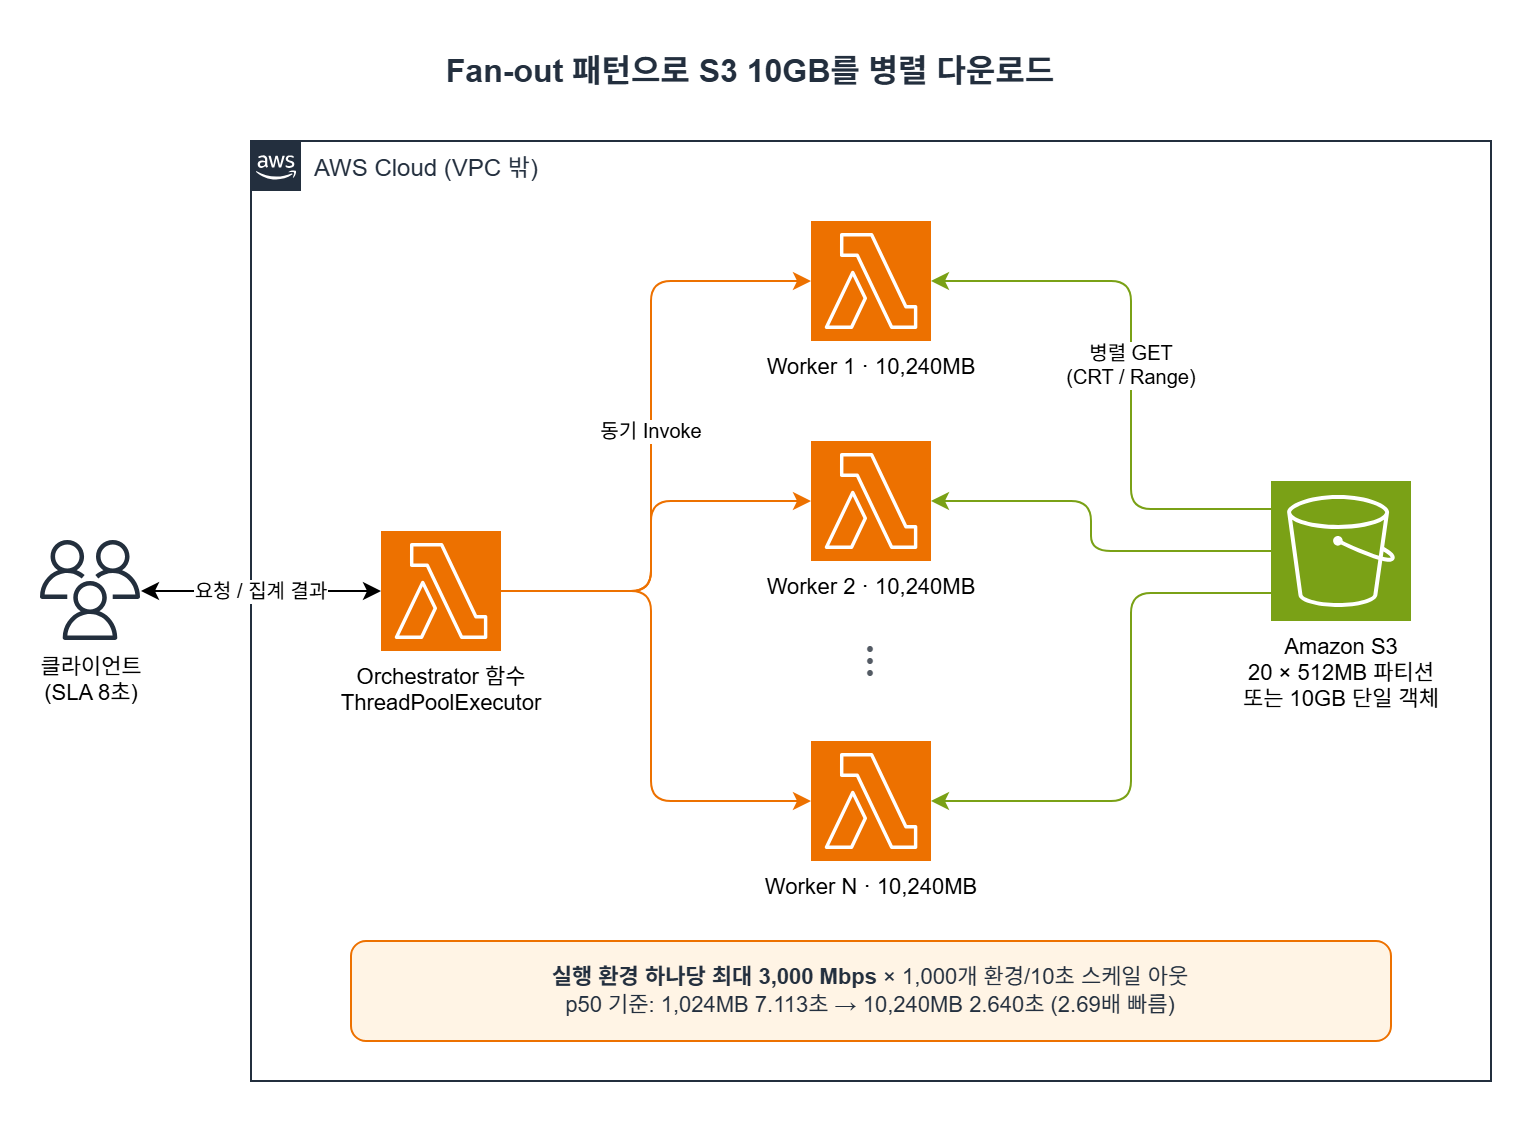
구조는 이렇습니다.
- 클라이언트가 오케스트레이터 함수를 호출합니다.
- 오케스트레이터는
ThreadPoolExecutor로 워커 함수 여러 개를 동기 호출합니다. - 각 워커는 S3에서 512MB씩 병렬로 내려받습니다. 데이터는 10GB를 512MB짜리 20개 파티션으로 나눠 두었습니다.
- 결과를 모아서 클라이언트에 돌려줍니다.
워커 메모리를 1,024MB(기존 625 Mbps 구간)와 10,240MB(최대 3,000 Mbps 구간)로 바꿔가며 같은 조건에서 측정한 결과입니다. 모두 p50(중앙값) 기준입니다.
| 워커 메모리 | 512MB 파티션 1개 다운로드 | 10GB fan-out 전체 시간 | 합산 처리량 |
|---|---|---|---|
| 1,024MB | 6.61초 / 649.8 Mbps | 7.113초 | 12.08 Gbps |
| 10,240MB | 1.70초 / 2,521.3 Mbps | 2.640초 | 32.54 Gbps |
1,024MB에서도 8초 SLA는 맞추지만 여유가 1초도 안 됩니다. 10,240MB로 올리면 2.640초로 줄어 2.69배 빨라지고 중앙값 지연이 62.9% 감소합니다. SLA 여유가 5초 가까이 생긴 셈입니다.
참고로 1,024MB 측정값이 649.8 Mbps로 625 Mbps를 살짝 넘는 건, Lambda가 짧은 순간의 버스트를 허용하기 때문입니다.
병렬 연결로 대역폭 채우기
단일 TCP 연결로는 3,000 Mbps를 다 채우지 못합니다. 그래서 AWS 샘플은 두 가지 방식으로 병렬성을 확보합니다.
모드 1: 미리 나눠둔 파티션
Boto3의 관리형 전송(download_file, download_fileobj)을 쓰고, AWS Common Runtime(CRT) 전송 클라이언트를 켭니다. CRT는 객체를 여러 파트로 쪼개 여러 TCP 연결로 동시에 받아옵니다.
import boto3
from boto3.s3.transfer import TransferConfig

s3 = boto3.client("s3")

# CRT 전송 클라이언트 우선 사용 (awscrt 패키지 필요)
config = TransferConfig(preferred_transfer_client="crt")

s3.download_file(
    Bucket="my-data-bucket",
    Key="partitions/part-0001.bin",
    Filename="/tmp/part-0001.bin",
    Config=config,
)
모드 2: 큰 단일 객체를 byte range로 쪼개기
10GB짜리 파일 하나를 512MB 범위로 나누고, 각 워커가 get_object의 Range 헤더로 자기 구간만 읽습니다. 이 경우 CRT 설정은 영향을 주지 않으니 워커 수와 스레드 풀 크기로 동시성을 조절합니다.
def read_range(bucket: str, key: str, start: int, end: int) -> bytes:
    resp = s3.get_object(Bucket=bucket, Key=key, Range=f"bytes={start}-{end}")
    return resp["Body"].read()
바로 써먹을 체크리스트
AWS 원문에서 소개한 모범 사례를 실무 순서대로 정리하면 이렇습니다.
- 먼저 측정하기. 모든 함수가 네트워크 병목은 아닙니다. CloudWatch Lambda Insights에서
rx_bytes,tx_bytes, duration을 보고 네트워크 I/O가 실행 시간을 지배하는지 확인합니다. - Power Tuning으로 메모리 스윕. AWS Lambda Power Tuning으로 1,024MB부터 10,240MB까지 돌려서 비용과 지연의 균형점을 찾습니다.
- 다운스트림 한도 확인. 함수 하나가 3,000 Mbps를 내면 S3 단일 prefix 한도(초당 GET 5,500건)에 걸릴 수 있습니다. 로그에 HTTP 503 Slow Down이 보이면 객체를 여러 prefix로 분산합니다.
- CPU도 같이 쓰기. Lambda는 메모리에 비례해 CPU를 줍니다. 1.769GB에서 vCPU 1개, 10GB에서 최대 6개입니다. Python은
concurrent.futures, Node.js는worker_threads로 받은 데이터를 병렬 처리해야 늘어난 대역폭이 의미가 있습니다. - SnapStart(Java)도 덕을 본다. restore 시점의
afterRestore훅에서 커넥션 예열이나 설정 프리페치를 한다면 그 부분도 빨라집니다.
비용은 어떻게 될까
Lambda는 메모리 × 실행 시간(GB-초)으로 과금합니다. 위 표의 파티션 다운로드 시간만 놓고 대략 계산해 보면 다음과 같습니다. (다운로드 외 처리 시간과 요청 요금은 빼고 계산했습니다.)
| 워커 메모리 | 512MB 파티션 1개 다운로드 | GB-초 |
|---|---|---|
| 1GB | 6.61초 | 약 6.6 |
| 10GB | 1.70초 | 약 17.0 |
같은 데이터를 받는 데 드는 컴퓨팅 비용은 10GB 쪽이 2.5배 정도 높습니다. 결국 이 기능은 "지연을 돈으로 사는" 선택지에 가깝습니다. SLA가 빠듯한 사용자 대면 쿼리라면 충분히 가치가 있고, 배치 작업처럼 시간이 넉넉하다면 굳이 10GB까지 올릴 필요가 없습니다. AWS는 SLA 여유가 생긴 만큼 워커 하나가 더 큰 파티션을 맡게 해서 워커 수를 줄이는 방향도 제안합니다. 실제 비용은 Power Tuning 결과로 판단하는 게 정확합니다.
2. Lambda metadata endpoint: 내가 어느 AZ에 있는지 알기
왜 필요한가
Lambda는 고가용성을 위해 실행 환경을 리전 내 여러 AZ에 자동으로 흩어 배치합니다. 편리하지만, 함수 코드는 지금까지 자기가 어느 AZ에 있는지 알 방법이 없었습니다.
예를 들어 ElastiCache 클러스터가 AZ 3곳에 노드를 하나씩 두고 있다고 해 봅시다. Lambda 실행 환경도 3개 AZ에 퍼지지만 배치는 캐시 노드 위치와 무관합니다. 그러면 대략 3번 중 2번은 다른 AZ의 캐시 노드와 통신하게 됩니다. 같은 AZ 왕복은 보통 한 자릿수 밀리초인데, AZ를 넘으면 지연이 더 붙고 경우에 따라 AZ 간 데이터 전송 요금도 나옵니다. 초당 수천 번 호출되는 읽기 경로라면 p99 지연과 비용 양쪽에서 무시하기 어렵습니다.
그동안은 함수 버전별 환경 변수에 AZ 힌트를 박아 넣거나 IP 대역으로 추측하는 식의 우회책뿐이었고, 어느 쪽도 믿을 만하지 않았습니다.
동작 방식
Lambda는 모든 실행 환경에 환경 변수 두 개를 자동으로 넣어줍니다.
| 환경 변수 | 설명 |
|---|---|
AWS_LAMBDA_METADATA_API |
메타데이터 서버 주소 ({ipv4}:{port}, 예: 169.254.100.1:9001) |
AWS_LAMBDA_METADATA_TOKEN |
실행 환경마다 초기화 시 생성되는 인증 토큰 |
이 값으로 GET 요청을 보내면 됩니다.
GET http://${AWS_LAMBDA_METADATA_API}/2026-01-15/metadata/execution-environment
Authorization: Bearer ${AWS_LAMBDA_METADATA_TOKEN}
응답은 단순합니다.
{
  "AvailabilityZoneID": "use1-az1"
}
알아둘 점은 다음과 같습니다.
- GET만 허용합니다. 다른 메서드는
405 Method Not Allowed입니다. - 토큰이 없거나 틀리면
401 Unauthorized입니다. 토큰 인증은 SSRF 공격에 대한 방어 장치입니다. - 응답 헤더는
Cache-Control: private, max-age=43200, immutable입니다. 실행 환경이 살아 있는 동안 값이 바뀌지 않으니 한 번 읽고 캐시하면 됩니다. - 응답에 필드가 추가될 수 있으니 모르는 필드는 무시하도록 파싱합니다.
- 모든 런타임(커스텀 런타임, 컨테이너 이미지 포함)에서 쓸 수 있고 SnapStart, 프로비저닝된 동시성, VPC 연결 함수와도 호환됩니다. 추가 요금은 없습니다.
AZ ID를 돌려주는 이유
엔드포인트는 us-east-1a 같은 AZ 이름이 아니라 use1-az1 같은 AZ ID를 돌려줍니다.
AZ 이름은 계정마다 실제 물리 위치가 다르게 매핑될 수 있습니다. 내 계정의 us-east-1a와 다른 계정의 us-east-1a가 서로 다른 데이터센터일 수 있다는 뜻입니다. 반면 AZ ID는 모든 계정에서 같은 물리 위치를 가리킵니다. 그래서 "이 함수와 저 캐시 노드가 같은 AZ에 있는가?"를 판단할 때는 반드시 AZ ID끼리 비교해야 합니다.
형식은 <리전 코드>-az<번호>입니다. use1은 us-east-1, usw2는 us-west-2, euw1은 eu-west-1입니다. 서울 리전(ap-northeast-2)은 apne2-az1 같은 형태가 됩니다.
로깅 등의 이유로 AZ 이름이 필요하면 EC2 DescribeAvailabilityZones API로 변환할 수 있고, 이때는 실행 역할에 ec2:DescribeAvailabilityZones 권한을 추가해야 합니다.
AZ ID 가져오기
Powertools for AWS Lambda 사용 (권장)
Python, TypeScript, Java, .NET을 지원합니다. 응답 캐싱과 SnapStart 복원 후 갱신을 알아서 처리해 줍니다.
# pip install "aws-lambda-powertools"
from aws_lambda_powertools.utilities.lambda_metadata import get_lambda_metadata

def handler(event, context):
    metadata = get_lambda_metadata()
    az_id = metadata.availability_zone_id  # 예: "use1-az1"
    return {"az_id": az_id}
// npm install @aws-lambda-powertools/commons
import { getMetadata } from '@aws-lambda-powertools/commons/utils/metadata';

const metadata = await getMetadata();

export const handler = async () => {
  const { AvailabilityZoneID: azId } = metadata;
  return azId;
};
의존성 없이 직접 호출
Powertools를 쓰기 어렵다면 표준 라이브러리만으로도 충분합니다. 아래는 Python urllib로 작성한 예시입니다.
import json
import os
import urllib.request

def fetch_az_id() -> str | None:
    api = os.environ.get("AWS_LAMBDA_METADATA_API")
    token = os.environ.get("AWS_LAMBDA_METADATA_TOKEN")
    if not api or not token:
        return None

    req = urllib.request.Request(
        f"http://{api}/2026-01-15/metadata/execution-environment",
        headers={"Authorization": f"Bearer {token}"},
    )
    try:
        with urllib.request.urlopen(req, timeout=1) as resp:
            return json.loads(resp.read()).get("AvailabilityZoneID")
    except Exception:
        return None  # 실패해도 함수는 계속 동작해야 한다

# 핸들러 밖, init 단계에서 한 번만 호출
AZ_ID = fetch_az_id()
토큰(AWS_LAMBDA_METADATA_TOKEN)은 실행 환경 하나에만 유효한 값이지만, 로그에 찍거나 함수 밖으로 내보내지 않도록 주의합니다.
같은 AZ의 ElastiCache 노드로 붙기
패턴은 간단합니다. init 단계에서 AZ ID를 한 번 읽고, 같은 AZ 노드를 고르고, 없으면 다른 노드로 fallback합니다.
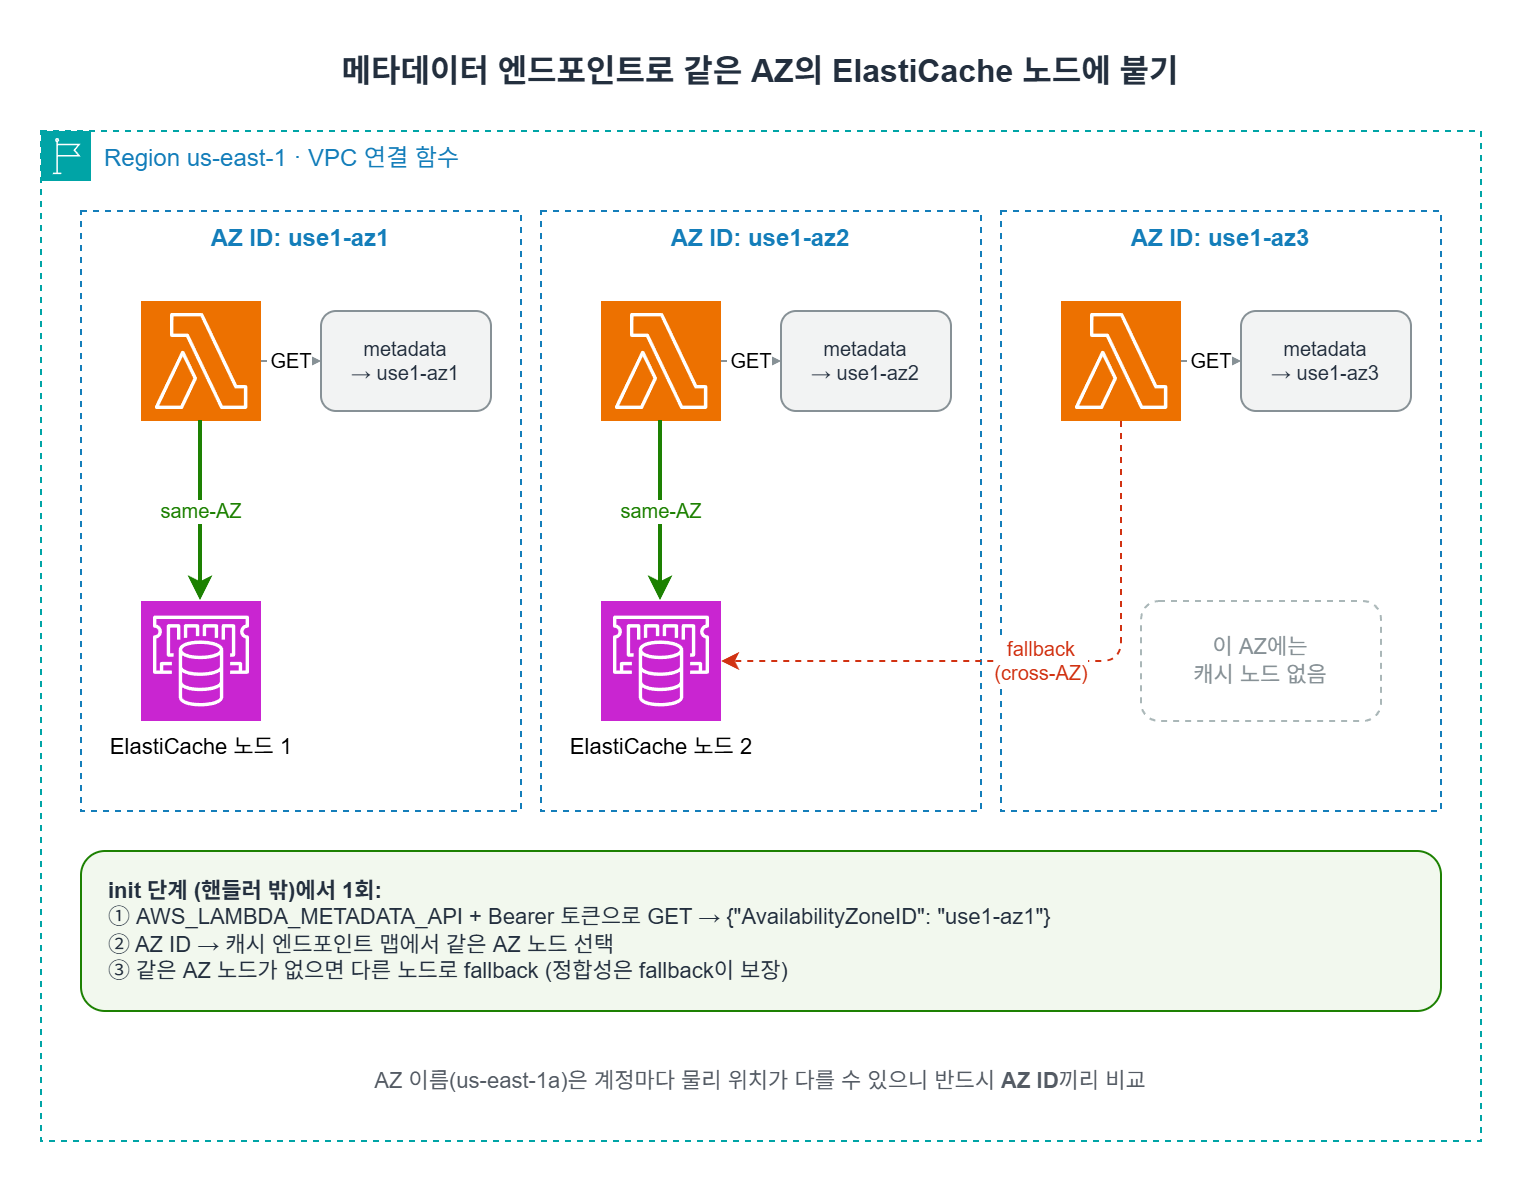
from aws_lambda_powertools.utilities.lambda_metadata import get_lambda_metadata

# 캐시 노드별 AZ ID 매핑.
# 실제로는 환경 변수나 Parameter Store에서 읽어오도록 구성한다.
CACHE_NODES_BY_AZ = {
    "use1-az1": "cache-node-1.example.use1-az1.cache.amazonaws.com",
    "use1-az2": "cache-node-2.example.use1-az2.cache.amazonaws.com",
    "use1-az3": "cache-node-3.example.use1-az3.cache.amazonaws.com",
}

# init 단계에서 한 번만 조회 (warm 호출에서는 재사용)
AZ_ID = get_lambda_metadata().availability_zone_id

# 같은 AZ 노드 우선, 없으면 아무 노드로 fallback
CACHE_ENDPOINT = CACHE_NODES_BY_AZ.get(AZ_ID) or next(iter(CACHE_NODES_BY_AZ.values()))

def handler(event, context):
    # 읽기 경로에서 CACHE_ENDPOINT 사용.
    # AZ_ID와 노드 AZ가 같으면 요청이 AZ 안에서 끝난다.
    return {"az_id": AZ_ID, "cache_endpoint": CACHE_ENDPOINT}
설계 포인트는 세 가지입니다.
- init에서 결정한다.
AZ_ID와CACHE_ENDPOINT는 실행 환경당 한 번만 계산되므로 요청 경로에 지연이 추가되지 않습니다. - fallback은 필수다. 서비스가 모든 AZ에 배포돼 있지 않을 수 있습니다. same-AZ 라우팅은 최적화일 뿐이고, 정합성이 여기에 기대면 안 됩니다.
- AZ ID끼리 비교한다. ElastiCache와 RDS는 노드의 AZ 정보를 노출하므로 메타데이터 엔드포인트 값과 바로 비교할 수 있습니다.
그 밖의 활용처
- Aurora / RDS 읽기 복제본: 읽기 위주 쿼리를 같은 AZ의 복제본으로 보내고, 없으면 다른 복제본으로 넘깁니다.
- MemoryDB: 결과적 일관성을 허용하는 읽기는 같은 AZ 복제본에서, 쓰기와 "방금 쓴 값을 읽어야 하는" 요청은 프라이머리로 보냅니다. 복제 지연이 있기 때문입니다.
- EKS / ECS 서비스 호출: Kubernetes Topology Aware Routing 같은 토폴로지 기반 라우팅과 함께 써서 east-west 트래픽을 AZ 안에 묶어둡니다.
- 내부 ALB, AWS Cloud Map: "아무 healthy 타깃"이 아니라 "가장 가까운 healthy 타깃"을 고를 수 있습니다.
- 장애 주입 테스트: 특정 AZ에서 도는 함수에만 장애를 주입해서 AZ 장애 상황을 다른 AZ 트래픽에 영향 없이 시뮬레이션할 수 있습니다.
SnapStart를 쓴다면
SnapStart로 복원된 실행 환경은 스냅샷을 찍은 AZ와 다른 AZ에서 깨어날 수 있습니다. 그래서 SnapStart 함수는 초기화 단계에서 캐시 TTL이 짧게 설정되고, 복원 후에는 AZ ID를 다시 읽어야 합니다. Powertools를 쓰면 이 처리가 자동이고, 직접 호출한다면 restore 훅에서 다시 조회하도록 구현해야 합니다.
3. 두 기능을 같이 쓸 때의 제약
여기서 함정이 하나 있습니다. 대역폭 스케일링은 VPC 밖 함수에만 적용되는데, ElastiCache나 RDS에 붙으려면 함수가 VPC에 연결돼 있어야 합니다. 즉 "10GB 메모리로 3,000 Mbps를 받으면서 같은 AZ 캐시에 붙는 함수 하나"는 지금 구조로는 만들 수 없습니다.
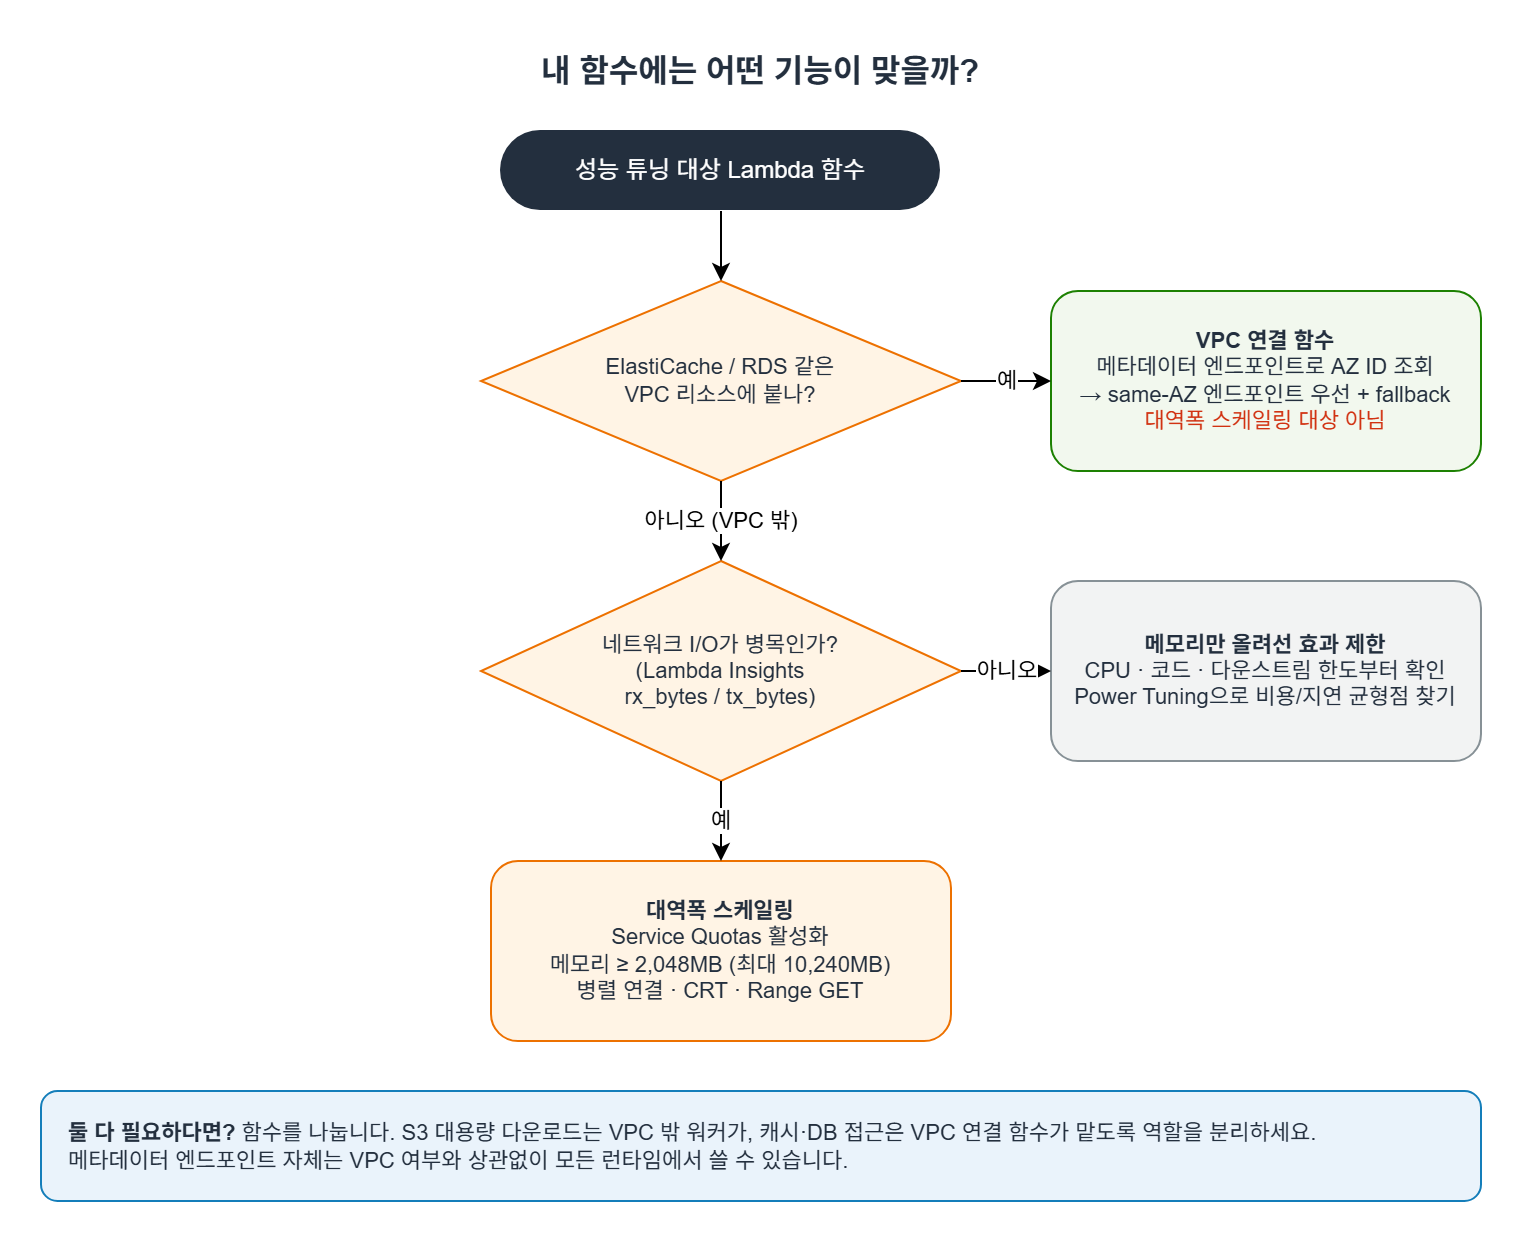
그래서 실무에서는 함수의 역할을 나누는 게 자연스럽습니다.
- S3 대용량 다운로드, 외부 API 대량 호출: VPC 밖 워커 함수가 맡고, 대역폭 스케일링으로 처리량을 끌어올립니다.
- 캐시·DB 접근이 잦은 지연 민감 경로: VPC 연결 함수가 맡고, 메타데이터 엔드포인트로 same-AZ 라우팅을 적용합니다.
메타데이터 엔드포인트 자체는 VPC 여부와 상관없이 동작하므로, VPC 밖 함수에서도 AZ ID를 로그·메트릭 차원으로 남겨 두면 AZ별 지연 분포를 분석할 때 유용합니다.
정리
| 항목 | Scalable network bandwidth | Lambda metadata endpoint |
|---|---|---|
| 발표 | 2026-09-28 | 2026-10-09 |
| 해결하는 문제 | 실행 환경당 625 Mbps 상한 | 함수가 자기 AZ를 모름 |
| 적용 대상 | VPC 밖 + 메모리 2,048MB 이상 | 모든 런타임, VPC 여부 무관 |
| 활성화 | Service Quotas 신청 (opt-in) | 별도 설정 없음 |
| 추가 요금 | 없음 (메모리 증가분 실행 비용은 별도) | 없음 |
| 핵심 사용법 | 병렬 연결 + CRT + Range GET | init에서 AZ ID 1회 조회 + fallback |
네트워크가 병목인 Lambda 함수라면 이제 튜닝할 수 있는 손잡이가 두 개 생겼습니다. 많이 받아야 하는 함수는 메모리를 올려서 대역폭을 늘리고, 자주 오가야 하는 함수는 같은 AZ 리소스로 붙여서 거리를 줄이면 됩니다. 어느 쪽이든 먼저 Lambda Insights로 실제 병목이 네트워크인지 확인하는 것부터 시작하시길 권합니다.
참고 자료
- Improving Lambda function latency with scalable network bandwidth (AWS Compute Blog, 2026-09-28)
- Reducing cross-AZ latency with the AWS Lambda metadata endpoint (AWS Compute Blog, 2026-10-09)
- Using the Lambda metadata endpoint (AWS Lambda Developer Guide)
- sample-lambda-enhanced-bandwidth (GitHub, aws-samples)
- AZ IDs for cross-account consistency (AWS 문서)
'AWS 서버리스' 카테고리의 다른 글
| Kafka 파티션 수에 묶이지 않는 Lambda 소비자: Queue consumption mode (0) | 2026.11.17 |
|---|---|
| Lambda Durable Functions vs Step Functions, 언제 무엇을 쓸까 (0) | 2026.11.16 |
| 2026 AWS Lambda 총정리: Event Functions, Web Functions, MicroVMs 무엇을 골라야 할까 (0) | 2026.11.15 |
| AWS Lambda Web Functions 정리: Lambda에서 Node.js HTTP 서버 그대로 돌리기 (0) | 2026.11.14 |
| Serverless Framework v3와 v4의 차이점 및 기존 프로젝트 마이그레이션 가이드 (0) | 2026.11.07 |