Kafka를 오래 써 본 사람이라면 "컨슈머를 더 붙이고 싶은데 파티션이 모자라다"는 상황을 한 번쯤 겪어 봤을 겁니다. 2026년 11월 2일, AWS Lambda의 Kafka 이벤트 소스 매핑(ESM)에 Queue consumption mode가 추가되면서 이 제약을 Lambda 쪽에서 풀 수 있게 됐습니다.
이 글에서는 먼저 Kafka 4.x에 들어온 Share Group(KIP-932) 이 무엇인지 정리하고, Lambda가 이를 어떻게 활용하는지, 설정과 주의할 점까지 차례로 살펴봅니다.
참고: Introducing queue consumption mode for Apache Kafka in AWS Lambda (AWS Compute Blog, 2026-11-02)
1. 왜 파티션 수가 병렬도의 상한이 되었나
Kafka의 기존 컨슈머 그룹(Consumer Group) 프로토콜에서는 하나의 파티션을 그룹 안의 컨슈머 하나만 읽습니다. 파티션 안에서의 순서를 보장하기 위한 설계죠.
그 결과 몇 가지 문제가 따라옵니다.
- 병렬도 상한 = 파티션 수. 파티션이 10개인 토픽은 컨슈머를 아무리 늘려도 동시에 10개까지만 일합니다. 11번째부터는 할당받을 파티션이 없어 놀게 됩니다.
- 파티션을 늘리는 비용. 파티션을 늘리면 상한은 올라가지만 브로커 부하가 커지고 리밸런싱이 느려집니다. 한 번 늘린 파티션은 줄일 수도 없습니다.
- Head-of-line blocking. 파티션 안에서 레코드 하나가 오래 걸리면 뒤에 있는 레코드들이 전부 기다립니다. 레코드끼리 순서가 전혀 상관없는 작업이어도 마찬가지입니다.
그래서 주문 알림 발송, 이미지 처리처럼 레코드끼리 독립적인 작업은 Kafka에서 SQS 같은 별도 큐로 옮기는 경우가 많았습니다. 데이터는 이미 Kafka에 있는데 큐를 하나 더 운영해야 했던 셈입니다.
Lambda도 예외는 아니었습니다. 기존 Kafka ESM에서는 파티션 하나가 동시에 하나의 Lambda 호출로만 처리되므로, 함수 동시성을 아무리 넉넉히 줘도 파티션 수를 넘을 수 없었습니다.
2. Share Group(KIP-932): Kafka에 들어온 큐 시맨틱
KIP-932: Queues for Kafka는 Kafka에 Share Group이라는 새 그룹 타입을 추가합니다. Kafka 4.0에서 처음 들어왔고 4.2부터 프로덕션 사용이 가능한 상태가 됐습니다.
이름은 "Queues for Kafka"지만 큐라는 별도 객체가 생기지는 않습니다. 기존 토픽은 그대로 두고 읽는 방식만 큐처럼 바뀌기 때문에, 프로듀서나 토픽 설정은 건드릴 필요가 없습니다.

컨슈머 그룹과 무엇이 다른가
| 구분 | Consumer Group | Share Group |
|---|---|---|
| 파티션 할당 | 파티션당 컨슈머 1개 (독점) | 여러 컨슈머가 같은 파티션을 공유 |
| 유효한 최대 컨슈머 수 | 파티션 수 | 파티션 수와 무관 |
| 진행 상황 추적 | 오프셋 커밋 | 레코드 단위 확인(acknowledge) |
| 재전달 | 커밋된 오프셋으로 되감기 | 레코드 단위, 전달 횟수 카운트 |
| 순서 보장 | 파티션 단위 | 한 번에 가져온 배치 안에서만 |
| 독성 메시지 처리 | 애플리케이션이 알아서 | 전달 횟수 제한 + REJECT |
Share Group은 진행 상황을 오프셋 하나로 기록하지 않고 레코드마다 따로 관리합니다. 그래서 여러 컨슈머가 같은 파티션에서 서로 다른 레코드를 동시에 가져갈 수 있습니다.
Share-partition과 in-flight 레코드
Share Group 안에서 각 토픽 파티션은 share-partition이라는 단위로 관리됩니다. 해당 파티션의 리더 브로커에 있는 share-partition leader가 어떤 레코드를 누가 가져갔는지 추적합니다.
- SPSO(Share-Partition Start Offset): 아직 처리 대상인 첫 오프셋
- SPEO(Share-Partition End Offset): 처리 대상인 마지막 오프셋
- 이 둘 사이가 in-flight 레코드이고, 그 개수는
group.share.partition.max.record.locks로 제한됩니다.
이 상태는 내부 토픽 __share_group_state에 저장됩니다.
레코드의 상태 변화
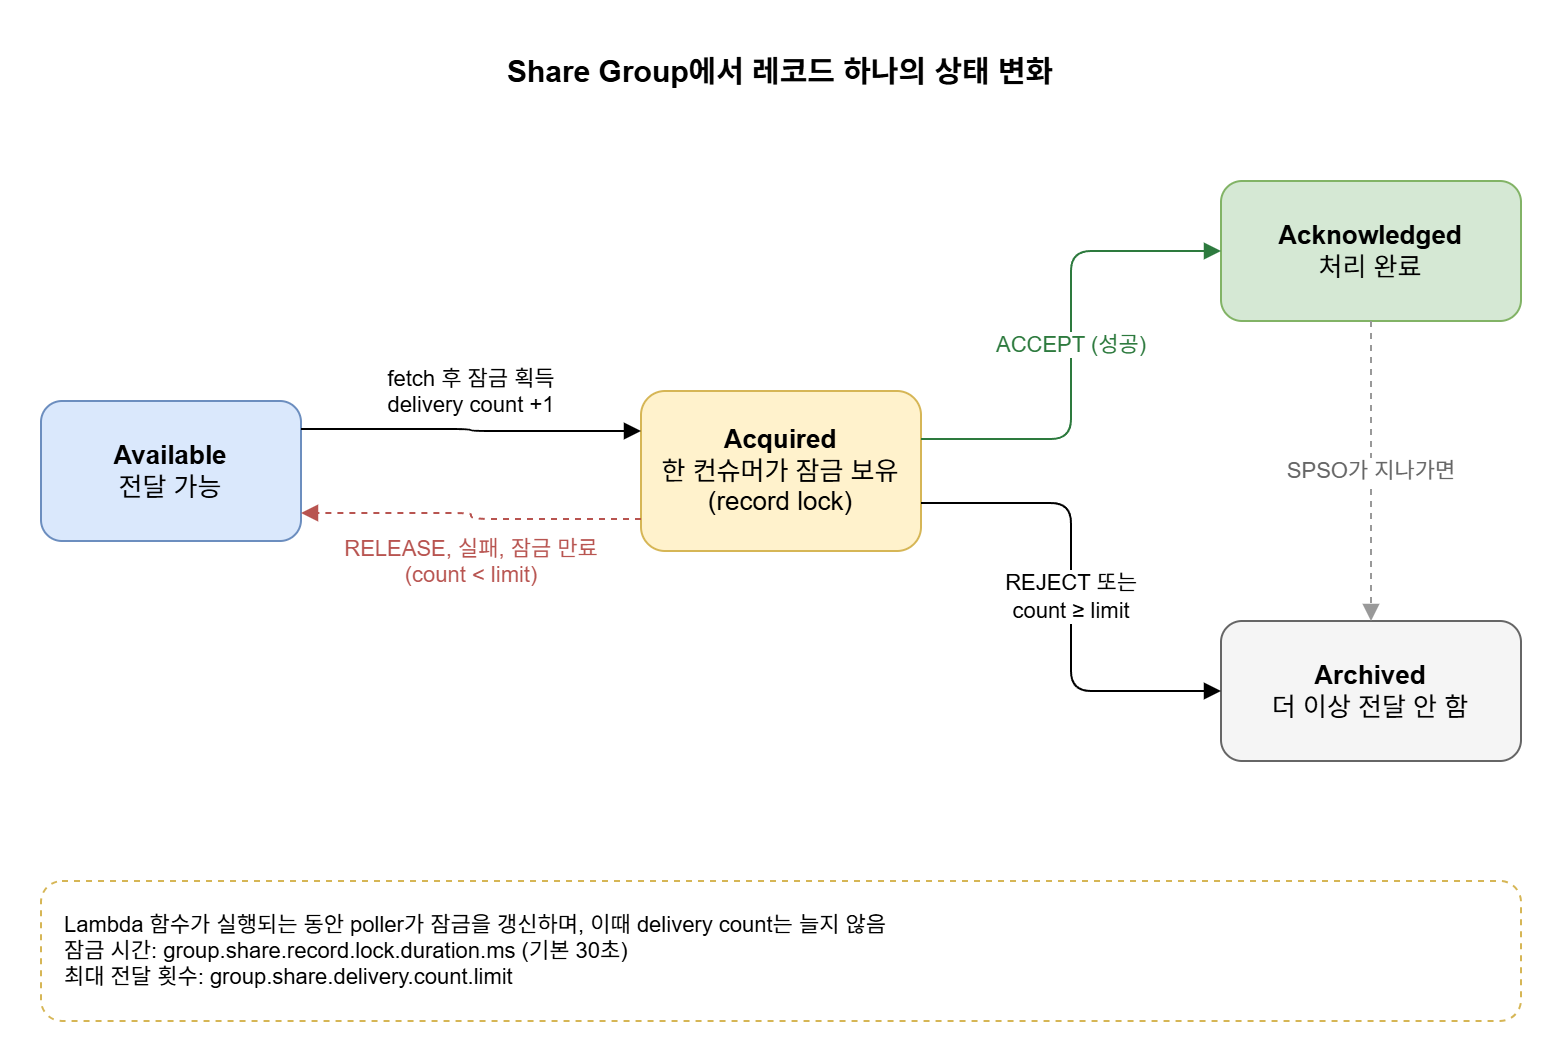
레코드는 다음 네 가지 상태를 거칩니다.
- Available: 아직 누구도 가져가지 않아 전달할 수 있는 상태
- Acquired: 한 컨슈머가 가져가서 잠금(lock)을 쥐고 있는 상태. 가져갈 때마다 delivery count가 1씩 올라갑니다.
- Acknowledged: 처리가 끝난 상태
- Archived: 더 이상 전달하지 않는 상태
컨슈머는 처리 결과를 세 가지 중 하나로 알려 줍니다.
- ACCEPT: 성공. Acknowledged로 갑니다.
- RELEASE: 일시적 실패. 다시 Available로 돌아가 다른 컨슈머가 가져갈 수 있습니다.
- REJECT: 처리 불가. 재전달하지 않고 Archived로 보냅니다.
아무 응답 없이 잠금 시간(group.share.record.lock.duration.ms, 기본 30초)이 지나면 RELEASE와 똑같이 Available로 돌아갑니다. 단, delivery count가 group.share.delivery.count.limit에 도달한 레코드는 Archived로 빠집니다. 같은 메시지 때문에 무한 재시도가 도는 걸 막는 장치입니다.
SQS를 써 봤다면 익숙한 구조입니다. Acquired는 visibility timeout 동안 메시지가 숨겨진 상태, delivery count는 ApproximateReceiveCount, delivery count limit은 maxReceiveCount와 비슷한 역할을 합니다.
3. Lambda의 Queue consumption mode
이번 업데이트로 Lambda Kafka ESM에 ConsumptionMode 파라미터가 생겼습니다.
Stream(기본값): 지금까지와 같은 방식. 컨슈머 그룹, 파티션당 하나, 순서 보장.Queue: Kafka Share Consumer를 사용. ESM의 poller들이 컨슈머 그룹 대신 share group에 참여합니다.
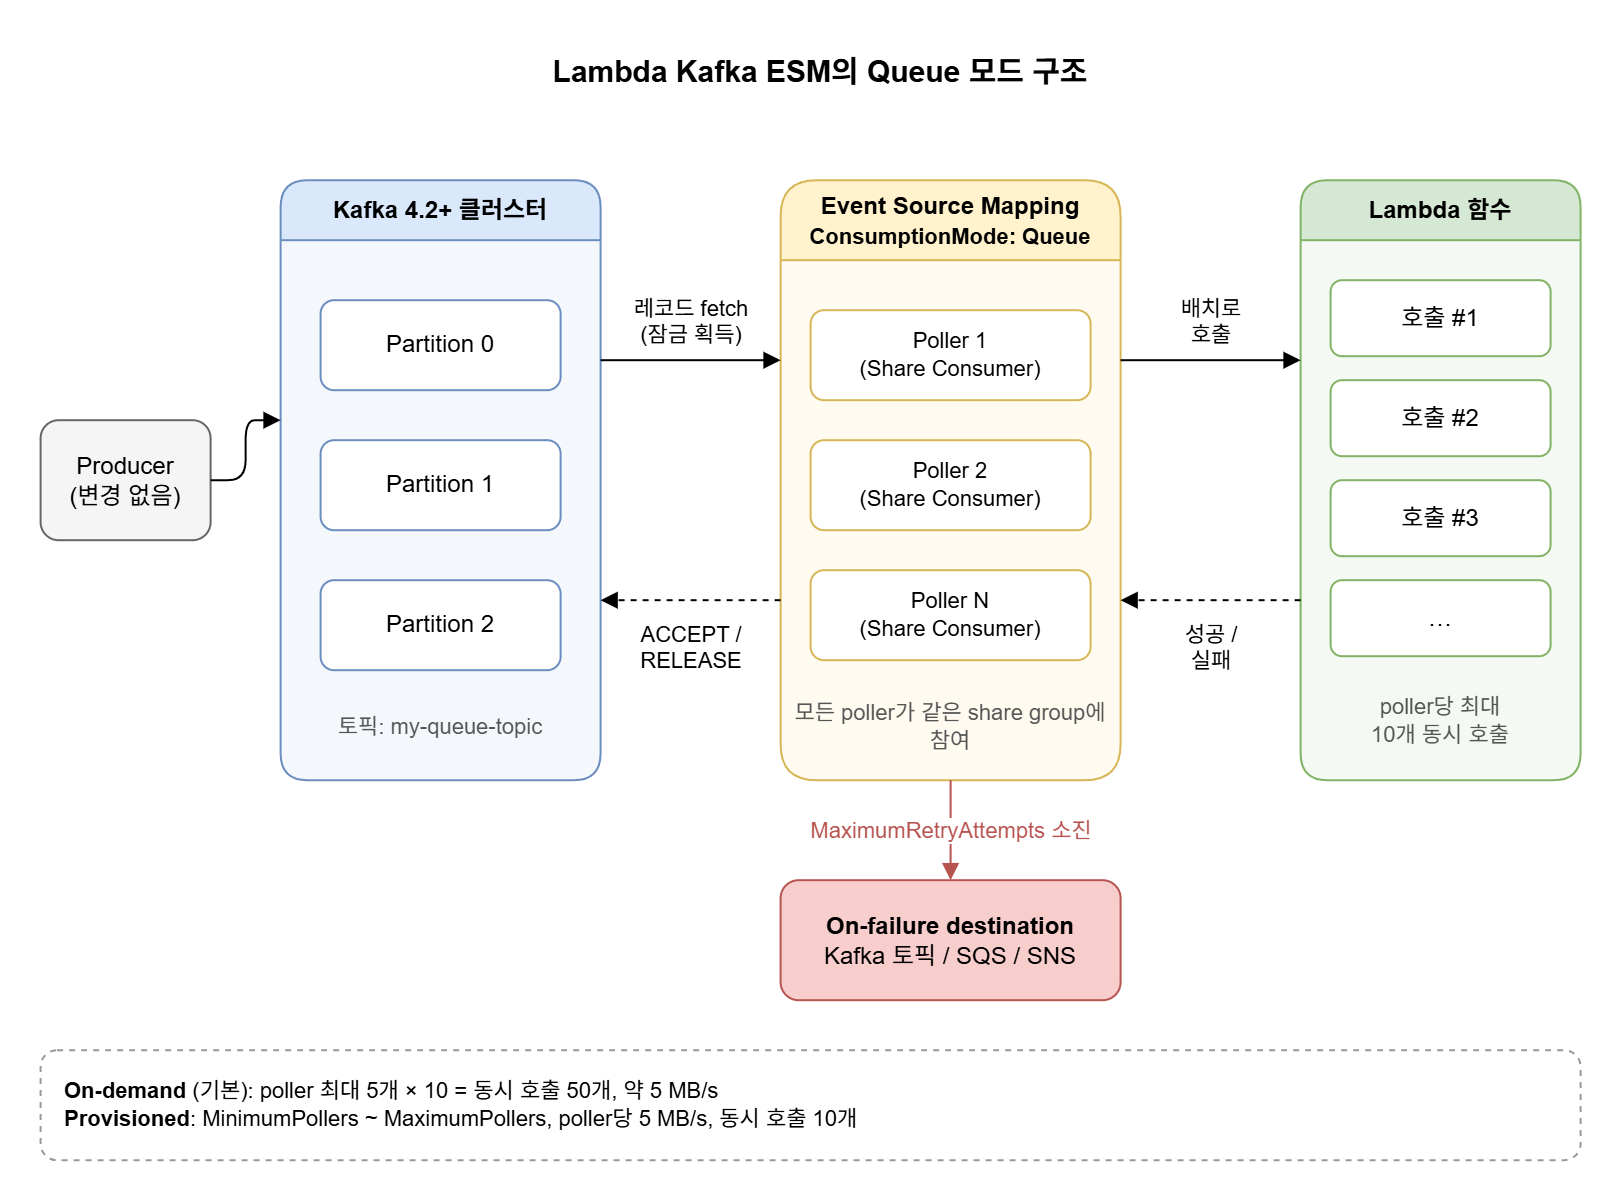
동작 흐름은 다음과 같습니다.
- ESM의 poller들이 하나의 share group에 참여해 같은 파티션들에서 레코드를 가져옵니다. 이때 레코드는 Acquired 상태가 됩니다.
- poller는 레코드를 배치로 묶어 Lambda 함수를 호출합니다. poller 하나가 최대 10개의 동시 호출을 만들 수 있습니다(Stream 모드는 5개).
- 함수가 실행되는 동안 poller가 잠금을 계속 갱신합니다. 갱신은 delivery count를 올리지 않으므로, 오래 걸리는 함수 때문에 재시도 횟수가 깎이지는 않습니다.
- 호출이 성공하면 레코드를 acknowledge하고, 실패하면 release해서 다른 poller가 다시 가져갈 수 있게 합니다.
- 재시도를 모두 소진한 레코드는 on-failure destination으로 보냅니다.
함수 코드는 그대로 두고 ESM 설정만 바꾸면 됩니다.
같은 토픽에 두 모드 함께 쓰기
ESM을 두 개 만들면 같은 토픽을 한쪽은 Stream 모드로 순서대로 집계하고, 다른 쪽은 Queue 모드로 레코드마다 병렬 처리할 수 있습니다. 컨슈머 그룹과 share group은 진행 상황을 따로 관리하기 때문입니다.
4. 사전 요구 사항
- Kafka 4.2 이상이면서 share group이 활성화된 클러스터
- Self-managed Apache Kafka ESM에서 사용 가능. 직접 운영하는 클러스터뿐 아니라 Confluent Cloud 같은 관리형 서비스도 4.2 이상 + share group 지원이면 쓸 수 있습니다.
브로커 쪽에서 확인할 설정은 다음과 같습니다.
| 설정 | 의미 |
|---|---|
group.share.partition.max.record.locks |
파티션당 in-flight 레코드 최대 개수. 기대하는 동시성에 맞게 넉넉히 |
group.share.record.lock.duration.ms |
Acquired 레코드의 잠금 시간. 기본 30초 |
group.share.delivery.count.limit |
레코드를 Archived로 보내기 전 최대 전달 횟수. Lambda의 MaximumRetryAttempts와 함께 동작 |
group.share.max.size |
share group에 들어올 수 있는 최대 컨슈머 수. Provisioned 모드의 MaximumPollers는 이 값 이하로 |
5. 설정 방법
ConsumptionMode 하나만 Queue로 주면 됩니다. BatchSize는 1~10,000(기본 100)입니다.
AWS CLI (On-demand)
aws lambda create-event-source-mapping \
  --function-name my-function \
  --self-managed-event-source '{"Endpoints":{"KAFKA_BOOTSTRAP_SERVERS":["broker1.example.com:9092","broker2.example.com:9092"]}}' \
  --topics my-queue-topic \
  --batch-size 100 \
  --self-managed-kafka-event-source-config '{"ConsumptionMode": "Queue"}'
AWS CLI (Provisioned)
aws lambda create-event-source-mapping \
  --function-name my-function \
  --self-managed-event-source '{"Endpoints":{"KAFKA_BOOTSTRAP_SERVERS":["broker1.example.com:9092"]}}' \
  --topics my-queue-topic \
  --self-managed-kafka-event-source-config '{"ConsumptionMode": "Queue"}' \
  --provisioned-poller-config '{"MinimumPollers": 5, "MaximumPollers": 100}' \
  --source-access-configurations '[{"Type":"VPC_SUBNET","URI":"subnet:subnet-xxxx"},{"Type":"VPC_SECURITY_GROUP","URI":"security_group:sg-xxxx"}]'
Provisioned에서 On-demand로 되돌리려면 빈 설정을 넣습니다.
aws lambda update-event-source-mapping --uuid <uuid> --provisioned-poller-config '{}'
CloudFormation
MyKafkaQueueESM:
  Type: AWS::Lambda::EventSourceMapping
  Properties:
    FunctionName: !Ref MyFunction
    SelfManagedEventSource:
      Endpoints:
        KafkaBootstrapServers:
          - broker1.example.com:9092
          - broker2.example.com:9092
    Topics:
      - my-queue-topic
    BatchSize: 100
    SelfManagedKafkaEventSourceConfig:
      ConsumptionMode: Queue
SDK, SAM, CDK에서도 지원하고, 콘솔에서는 트리거 추가 → Self-managed Apache Kafka → Consumption mode를 Queue로 선택하면 됩니다.
6. 스케일링
On-demand 모드 (기본)
- Lambda가 1분마다 share group의 consumer lag을 보고 poller를 늘리거나 줄입니다. 조정은 3분 안에 끝납니다.
- ESM당 poller는 최대 5개, poller당 약 1 MB/s.
- 따라서 상한은 5 MB/s 또는 동시 호출 50개 중 먼저 닿는 쪽입니다.
- 일반 Lambda 호출 비용 외에 추가 요금은 없습니다.
Provisioned 모드
MinimumPollers(1200),2,000)를 지정합니다. 단, Kafka 4.2의MaximumPollers(1group.share.max.size상한이 1,000이므로 브로커 설정을 바꾸지 않았다면MaximumPollers는 1,000 이하로 둡니다.- poller당 최대 5 MB/s, 동시 호출 10개.
- 크기 산정은 기준 처리량 ÷ 5 MB/s 또는 목표 동시 호출 수 ÷ 10으로 하면 됩니다. 예를 들어 동시 호출 300개가 필요하면 poller 30개가 필요합니다.
- 두 값을 같게 주면 오토스케일링 없이 용량이 고정됩니다.
- 저지연 처리, 스키마 레지스트리 필터링(Avro, Protobuf), ESM 그룹핑은 Provisioned 모드에서만 됩니다.
- 요금은 Event Poller Unit(EPU) 사용량 기준입니다.
- 여러 Queue 모드 ESM이
PollerGroupName으로 EPU를 공유할 수 있습니다(그룹당 ESM 100개, 합산 MaximumPollers 2,000개). Stream 모드 ESM과 같은 그룹 이름을 쓰면 검증 오류가 납니다.
7. 실패 처리
| 설정 | 설명 |
|---|---|
MaximumRetryAttempts |
0~10,000. 기본값 -1(무한 재시도) |
BisectBatchOnFunctionError |
실패한 배치를 반으로 쪼개 다시 시도. 문제 레코드를 찾아낼 때 유용 |
| On-failure destination | 재시도를 소진한 레코드를 Kafka 토픽, SQS, SNS로 보냄 |
기본값이 무한 재시도라는 점은 꼭 기억해 두세요. 처리할 수 없는 레코드가 하나 섞이면 계속 돌아옵니다. MaximumRetryAttempts와 on-failure destination은 함께 설정하는 걸 권합니다.
진단이 필요하면 ESM 로그를 CloudWatch Logs로 보낼 수 있습니다.
8. 쓰기 전에 알아 둘 제약
- 순서 보장이 없습니다. 같은 파티션 안에서도 순서가 뒤바뀔 수 있습니다. 순서가 중요한 워크로드라면 Stream 모드를 써야 합니다.
- 중복 처리가 가능합니다. at-least-once이므로 함수는 멱등하게 작성해야 합니다.
- Batching window를 쓸 수 없습니다.
MaximumBatchingWindowInSeconds를 주면 검증 오류가 납니다. - 시작 위치를 지정할 수 없습니다.
StartingPosition,StartingPositionTimestamp는 지원하지 않습니다. 새 share group이 어디서부터 읽을지는 브로커 설정share.auto.offset.reset으로 정합니다. - 필터 패턴은 ESM당 최대 5개입니다.
9. 언제 Queue 모드를 고를까
Queue 모드가 맞는 경우
- 레코드끼리 순서가 상관없는 작업 (알림 발송, 이미지·문서 처리, 외부 API 호출 등)
- 레코드 하나 처리 시간이 들쭉날쭉해서 head-of-line blocking이 문제였던 경우
- 파티션은 적은데 순간적으로 처리량을 크게 늘려야 하는 경우
- Kafka 데이터를 SQS로 옮겨 담는 파이프라인을 따로 운영하고 있던 경우
Stream 모드가 맞는 경우
- 같은 키의 이벤트를 순서대로 처리해야 하는 경우 (계좌 잔액, 상태 머신, CDC 반영 등)
- 처리 위치를 특정 오프셋이나 시점으로 지정해야 하는 경우
마무리
지금까지 Kafka에서 병렬도를 올리는 방법은 사실상 파티션을 늘리는 것뿐이었습니다. Share Group이 들어오면서 병렬도를 파티션 수와 따로 가져갈 수 있게 됐고, Lambda에서는 ESM 설정 한 줄이면 됩니다. 프로듀서, 토픽, 함수 코드는 그대로 두고 소비 방식만 바꾸는 셈입니다.
다만 Kafka 4.2 이상이 필요하고, 순서 보장과 시작 위치 지정은 포기해야 합니다. 클러스터 버전이 맞고 레코드끼리 독립적인 워크로드라면, 별도 큐를 따로 두던 구조를 정리해 볼 만합니다.
참고 자료
'AWS 서버리스' 카테고리의 다른 글
| Lambda Durable Functions vs Step Functions, 언제 무엇을 쓸까 (0) | 2026.11.16 |
|---|---|
| 2026 AWS Lambda 총정리: Event Functions, Web Functions, MicroVMs 무엇을 골라야 할까 (0) | 2026.11.15 |
| AWS Lambda Web Functions 정리: Lambda에서 Node.js HTTP 서버 그대로 돌리기 (0) | 2026.11.14 |
| Serverless Framework v3와 v4의 차이점 및 기존 프로젝트 마이그레이션 가이드 (0) | 2026.11.07 |
| AWS Lambda Python 로깅 시스템 분석: 중복 로그와 Request ID를 해결하는 방법 (0) | 2026.11.03 |